در حال بارگذاری صفحه...

جستجو در
Ctrl K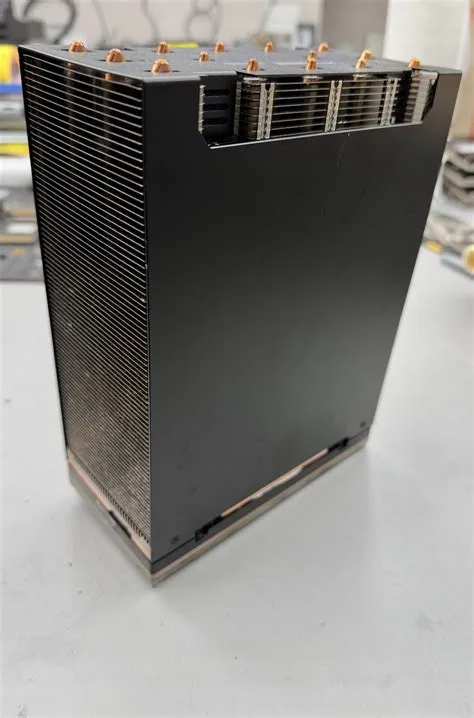
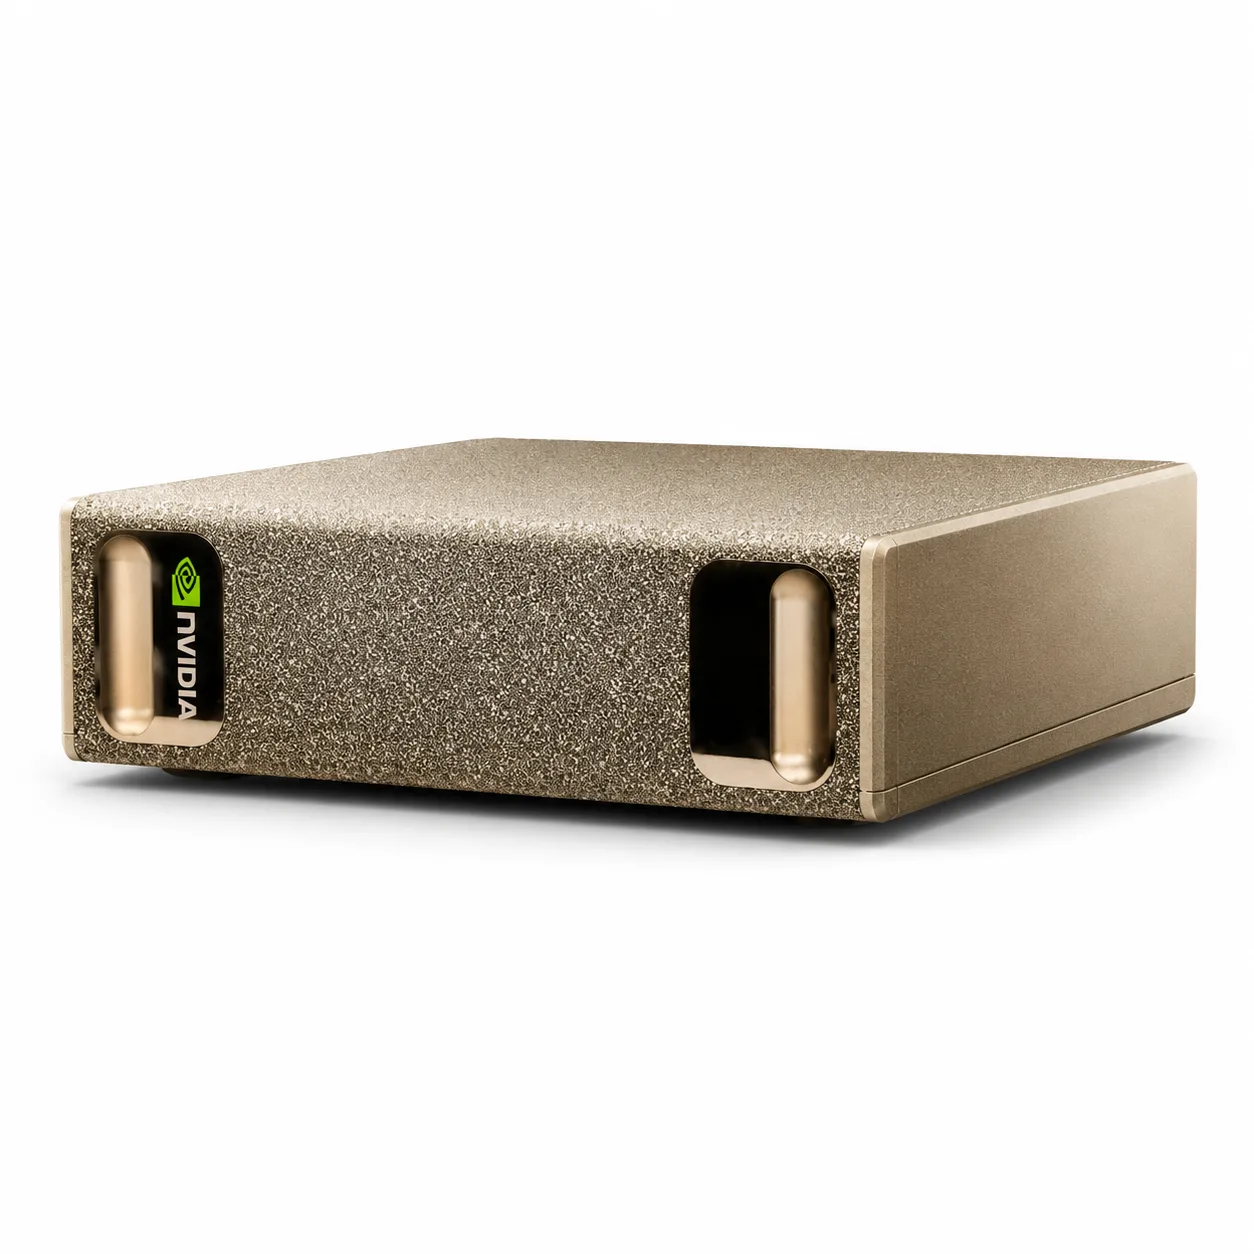
NVIDIA B200 SXM6 180GB HBM3e یک شتابدهنده فوقحرفهای دیتاسنتر مبتنی بر معماری NVIDIA Blackwell است که برای سنگینترین پردازشهای هوش مصنوعی، مدلهای زبانی بزرگ، Generative AI، AI Training، AI Inference، Data Analytics و HPC طراحی شده است.
B200 یکی از مهمترین جهشهای معماری NVIDIA در حوزه پردازش هوش مصنوعی محسوب میشود. این GPU از Tensor Coreهای نسل پنجم و نسل دوم Transformer Engine بهره میبرد و از دقتهای جدیدی مانند FP4 برای افزایش سرعت پردازش مدلهای بزرگ هوش مصنوعی پشتیبانی میکند.
وجود 180 گیگابایت حافظه HBM3e با پهنای باند بسیار بالا، B200 را برای مدلهایی که به حجم عظیمی از حافظه GPU و سرعت انتقال داده بالا نیاز دارند، به یک شتابدهنده فوققدرتمند تبدیل کرده است.
| معماری GPU | NVIDIA Blackwell |
| فرم فاکتور | SXM6 |
| حافظه GPU | 180GB HBM3e |
| پهنای باند حافظه | تا حدود 8TB/s |
| FP64 | حدود 37 تا 40 TFLOPS |
| FP32 | حدود 75 تا 80 TFLOPS |
| TF32 Tensor Core | 1.1 PFLOPS Dense / 2.2 PFLOPS با Sparsity |
| FP16 / BFLOAT16 Tensor Core | 2.25 PFLOPS Dense / 4.5 PFLOPS با Sparsity |
| FP8 Tensor Core | 4.5 PFLOPS Dense / 9 PFLOPS با Sparsity |
| FP4 Tensor Core | 9 PFLOPS Dense / 18 PFLOPS با Sparsity |
| نسل Tensor Core | نسل پنجم |
| Transformer Engine | نسل دوم NVIDIA Transformer Engine |
| NVLink | NVIDIA NVLink نسل پنجم |
| پهنای باند GPU-to-GPU | تا 1.8TB/s در پلتفرم HGX B200 |
| Host Interface | PCIe Gen5 تا 128GB/s |
| Multi-Instance GPU | تا 7 نمونه MIG |
| توان GPU | تا 1000 وات بسته به پلتفرم و تنظیمات |
حافظه GPU یکی از مهمترین عوامل در اجرای مدلهای بزرگ هوش مصنوعی است. NVIDIA B200 با 180GB حافظه HBM3e فضای بسیار زیادی برای ذخیره وزنهای مدل، KV Cache، دادههای پردازشی و Tensorهای بزرگ فراهم میکند.
NVIDIA در پلتفرم HGX B200 پهنای باند حافظه هر GPU را تا 8 ترابایت بر ثانیه اعلام کرده است. این مقدار بهطور قابل توجهی بیشتر از 4.8TB/s در H200 است.
Blackwell برای نسل جدید AI Factoryها و مدلهای دارای صدها میلیارد تا چند تریلیون پارامتر طراحی شده است.
NVIDIA در Blackwell از دو Die بزرگ که با یک اتصال پرسرعت 10TB/s Chip-to-Chip به یکدیگر متصل شدهاند استفاده میکند تا سیستم آنها را مانند یک GPU یکپارچه مشاهده کند.
نسل جدید Tensor Coreهای Blackwell از دقت FP4 پشتیبانی میکند.
B200 در Workloadهای سازگار میتواند تا حدود 9 PFLOPS عملکرد Dense FP4 و تا 18 PFLOPS با Structural Sparsity ارائه کند.
این قابلیت مخصوصاً برای LLM Inference و مدلهای Mixture-of-Experts اهمیت زیادی دارد؛ زیرا میتواند Throughput بالاتری را با استفاده مؤثرتر از منابع محاسباتی فراهم کند.
NVIDIA B200 از Transformer Engine نسل دوم استفاده میکند که برای Training و Inference مدلهای Transformer، Large Language Model و Mixture-of-Experts بهینه شده است.
Transformer Engine میتواند Precision مناسب را متناسب با Workload انتخاب کند تا میان سرعت، مصرف حافظه و دقت مدل تعادل مناسبی برقرار شود.
ترکیب 180GB حافظه HBM3e، Tensor Coreهای نسل پنجم، FP4 و FP8، Transformer Engine نسل دوم و NVLink پرسرعت، B200 را برای مدلهای زبانی بزرگ و Generative AI به یک GPU دیتاسنتری بسیار قدرتمند تبدیل کرده است.
این شتابدهنده برای LLM Training، Fine-Tuning، Inference، RAG، AI Agentها و سرویسهای Generative AI در مقیاس بالا مناسب است.
در مدلهای بسیار بزرگ، یک GPU بهتنهایی همیشه کافی نیست. به همین دلیل B200 برای استفاده در پلتفرمهای Multi-GPU مانند NVIDIA HGX B200 طراحی شده است.
NVLink نسل پنجم در HGX B200 پهنای باند GPU-to-GPU تا 1.8TB/s فراهم میکند و ارتباط سریع میان شتابدهندهها را در Training و Inference توزیعشده ممکن میسازد.
پلتفرم HGX B200 از هشت GPU Blackwell B200 استفاده میکند.
هشت B200 با حافظه 180GB برای هر GPU، در مجموع 1,440GB یا 1.44TB حافظه GPU فراهم میکنند و پهنای باند تجمعی حافظه میتواند به حدود 64TB/s برسد.
NVIDIA B200 از Multi-Instance GPU پشتیبانی میکند و میتواند منابع یک GPU را میان چند Workload یا کاربر مستقل تقسیم کند.
این قابلیت برای دیتاسنترها، Cloud GPU Providerها و سازمانهایی که قصد دارند منابع GPU را بهصورت منعطف تخصیص دهند بسیار کاربردی است.
B200 فقط برای مدلهای زبانی ساخته نشده است. این GPU در پردازشهای High Performance Computing، Scientific Computing، Data Analytics و Simulation نیز کاربرد دارد.
Blackwell همچنین دارای Decompression Engine اختصاصی است که برای شتابدهی پردازش داده و Queryهای دیتابیس طراحی شده است.
| مشخصات | NVIDIA B200 | NVIDIA H200 |
|---|---|---|
| معماری | Blackwell | Hopper |
| حافظه | 180GB HBM3e | 141GB HBM3e |
| پهنای باند حافظه | تا 8TB/s | 4.8TB/s |
| FP4 | پشتیبانی میشود | — |
| Transformer Engine | نسل دوم | نسل اول |
| فرم فاکتور | SXM6 | SXM5 |
B200 مورد استفاده در HGX B200 دارای 180GB حافظه HBM3e برای هر GPU است.
پهنای باند حافظه هر B200 در پلتفرم HGX تا حدود 8TB/s اعلام شده است.
بله. B200 با 180GB HBM3e، Tensor Coreهای نسل پنجم، FP4، FP8 و Transformer Engine نسل دوم برای Training و Inference مدلهای زبانی بزرگ طراحی شده است.
خیر. B200 یک ماژول SXM6 است و برای پلتفرمهای سازگار مانند HGX B200 طراحی شده است.
پیکربندی رایج B200 SXM6 میتواند تا 1000 وات برای هر GPU مصرف داشته باشد و به زیرساخت خنکسازی و توان دیتاسنتری مناسب نیاز دارد.
* مقادیر Tensor Core با توجه به حالت Dense یا Structural Sparsity متفاوت هستند. مشخصات توان و پهنای باند ممکن است بر اساس پلتفرم و پیکربندی OEM متفاوت باشد.
هنوز نظری برای این محصول ثبت نشده است.
هنوز سوالی برای این محصول ثبت نشده است.
شتابدهنده NVIDIA B200 SXM6 180GB HBM3e